On-Device KI in der Praxis: Wie eine App Kassenbons offline ausliest
Fast jede Beleg-Scanner-App funktioniert gleich: Foto hochladen, Server liest aus, Ergebnis zurück. Das ist schnell und günstig für das Gerät, aber teuer für die Privatsphäre. Für BonBunker sind wir den anderen Weg gegangen: Ein KI-Modell liest Kassenbons komplett auf dem Smartphone aus, ohne dass ein Foto das Gerät verlässt.
In diesem Beitrag zeigen wir, wie On-Device KI in einer echten App aussieht, wo sie heute an Grenzen stößt und welche Entscheidungen wir dabei getroffen haben. Für alle, die selbst überlegen, KI direkt in eine App einzubauen.
Warum On-Device KI für Kassenbons?
- Datenschutz: Kassenbons verraten viel über Wohnort, Gewohnheiten und Gesundheit. Was das Gerät nicht verlässt, kann auch nicht auf einem Server liegen. Mehr dazu in Kassenzettel scannen ohne Cloud.
- Offline-Fähigkeit: Nach dem einmaligen Modell-Download funktioniert das Auslesen ohne Internet.
- Kein Konto und keine Server-Infrastruktur pro Scan: Ohne Backend für die Erkennung braucht die App auch kein Nutzerkonto.
- Vertrauen: „Deine Daten bleiben auf dem Gerät“ ist eine Aussage, die sich technisch überprüfen lässt, statt nur ein Versprechen in der Datenschutzerklärung.
Die Pipeline im Überblick
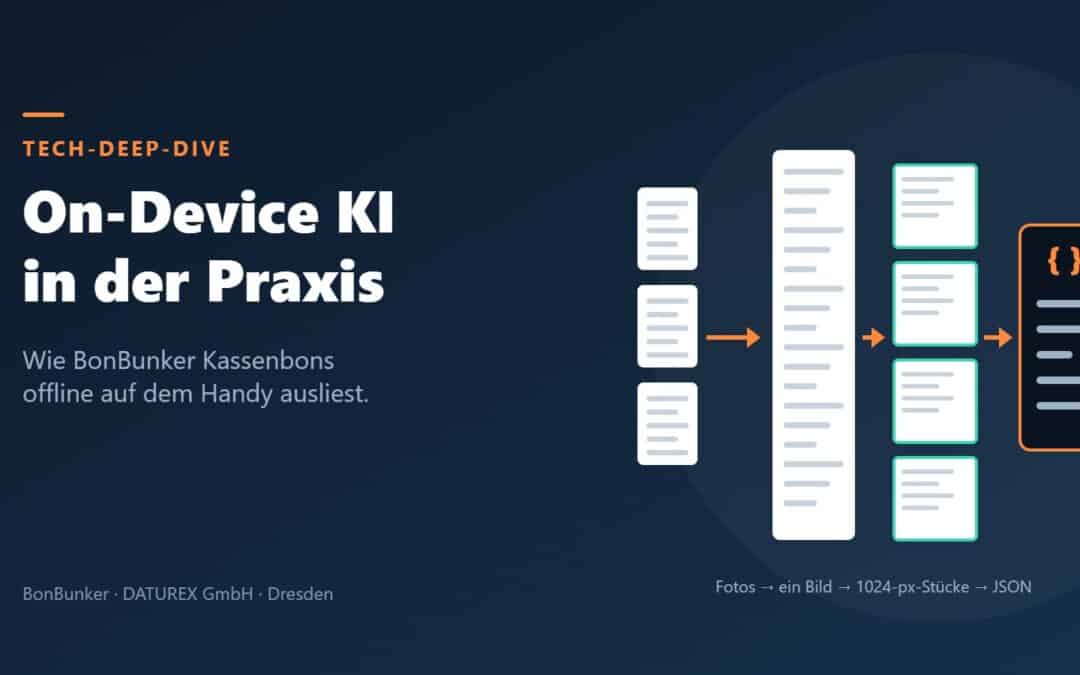
- Aufnahme: Du fotografierst den Bon in hoher Auflösung, lange Kassenzettel in mehreren Teilen.
- Automatischer Zuschnitt: Ein kleines Segmentierungsnetz (3,7 MB, arbeitet auf 256 × 256 Pixeln) findet das Papier und schlägt einen Rahmen vor, den du korrigieren kannst. Trainiert wurde es darauf, ein großes Segmentierungsmodell nachzuahmen. Bei Bedarf drehst du das Bild per Knopf in Vierteldrehungen.
- Zusammensetzen: Jedes Foto wird einzeln zugeschnitten, danach werden alle Teile von oben nach unten zu einem einzigen hohen Bild gestapelt.
- Zerlegen fürs Modell: Das hohe Bild wird auf 1024 Pixel Breite skaliert und in Stücke von bis zu 1024 Pixeln Höhe geschnitten, mit 200 Pixeln Überlappung, damit keine Zeile an einer Schnittkante verloren geht. Jedes Stück landet oben links auf einem weißen Quadrat von 1024 × 1024 Pixeln.
- Auslesen in einem Durchgang: Alle Stücke gehen gemeinsam in einen Prompt, die Anweisung steht zuletzt. Das Vision-Language-Modell liest sie in einem Durchgang und gibt ein einziges JSON mit Geschäft, Datum, Artikeln und Summe aus.
- Plausibilitätsprüfung: Die App rechnet nach, ob die Artikel zur Gesamtsumme auf dem Bon passen.
- Prüfen und korrigieren: Das Ergebnis erscheint direkt neben dem Foto, und du kannst jedes Feld anpassen.
- Einordnen: Kategorien werden auf Basis deiner früheren Zuordnungen vorgeschlagen.
Erst zuschneiden, dann verkleinern
Ein kleines Detail mit großer Wirkung: Gespeichert wird ein Bild mit höchstens 2048 Pixeln Breite (JPEG, Qualität 90), das Modell sieht höchstens 1024 Pixel Breite. Hochskaliert wird nie. Entscheidend ist die Reihenfolge: Die Größe wird erst nach dem Zuschnitt begrenzt. Würde man das ganze Kamerabild vorher verkleinern, hätte ein Bon, der nur einen Teil des Fotos füllt, am Ende weniger Pixel, als das Modell verarbeiten könnte. Bewusst verzichten wir dagegen auf Entzerrung und Kontrastanpassung.
Inferenz exakt wie im Training
Prompt, Stückelung und Dekodierung sind in der App identisch mit der Trainings-Pipeline. Jede Abweichung kostet messbar Genauigkeit. Gelesen wird mit Temperatur 0 (greedy), damit dasselbe Foto immer dasselbe Ergebnis liefert, bei 8192 Tokens Kontext und höchstens 2048 Tokens Antwort.
Warum ein generatives Modell statt klassischer OCR?
Klassische Texterkennung liefert Textzeilen. Ein Kassenbon ist aber mehr als Text: Welche Zahl ist der Preis, welche die Menge, welche das Pfand? Ist „-0,50“ ein Rabatt auf die Zeile darüber? Steht das „A“ am Zeilenende für den Mehrwertsteuersatz? Mit klassischer OCR braucht man dafür Regeln, und die brechen bei jedem neuen Layout.
Ein Vision-Language-Modell versteht Text und Layout gemeinsam und kann die Struktur direkt ausgeben. Als Grundlage dient uns das kompakte Dokumentmodell OvisOCR2, das wir speziell auf Kassenbons nachtrainiert haben. Wie das abgelaufen ist, welche Modelle wir verglichen haben und welche Messwerte dabei herauskamen, beschreiben wir in OvisOCR2 Fine-Tuning: Ein Dokumentmodell lernt Kassenbons lesen.
Runtime: Flutter, LiteRT-LM und ein quantisiertes Modell
BonBunker ist eine Flutter-App. Für die Inferenz nutzen wir Flutter Edge AI (früher flutter_gemma), ein Open-Source-Paket, das Sprachmodelle direkt auf dem Gerät ausführt, mit LiteRT-LM als Backend. Das nachtrainierte Modell wird dafür quantisiert und ins .litertlm-Format konvertiert. Die Konvertierung hat es ohne messbaren Genauigkeitsverlust überstanden. Damit die App weiß, was das jeweilige Gerät leisten kann, erstellt sie Hardware-Profile für CPU und GPU.
Die ehrlichen Kosten: Minuten, Gigabytes, Arbeitsspeicher
On-Device KI ist kein Gratis-Upgrade. Diese Kompromisse kommunizieren wir offen im Store-Eintrag:
- Laufzeit: Das Auslesen eines Belegs dauert etwa 5 Minuten auf einem Galaxy S22 Ultra. Generative Modelle erzeugen ihre Antwort Token für Token, und ein langer Bon mit vielen Positionen bedeutet viele Token. Auf einem Smartphone summiert sich das.
- Modellgröße: Etwa 1,9 GB, die einmalig heruntergeladen werden.
- Hardware: Android 11 oder neuer, viel Arbeitsspeicher und freier Speicherplatz.
Hintergrundverarbeitung: Android rechnet mit, iOS nicht
Fünf Minuten auf einen Ladebalken zu starren, ist niemandem zuzumuten. Deshalb läuft das Auslesen auf Android in einem Foreground Service vom Typ dataSync (über das Paket flutter_foreground_task). Eine Benachrichtigung zeigt den Fortschritt und hat einen Stopp-Knopf, ein Wake-Lock hält die Verarbeitung am Laufen. Belege landen in einer Warteschlange und werden nacheinander abgearbeitet. WorkManager nutzen wir dafür nicht.
Trotzdem gilt: Das Betriebssystem kann einen Prozess jederzeit beenden. Der Code rechnet ausdrücklich damit. Ein unterbrochener Beleg kommt beim nächsten Start zurück in die Warteschlange. Wird er zweimal abgebrochen, gibt die App ihn auf, statt ihn endlos neu zu lesen. Auch die Hardware-Messung wird Schritt für Schritt gespeichert, damit ein Abbruch nur den gerade laufenden Schritt kostet.
Auf iOS gibt es keinen vergleichbaren Dienst. Dort läuft das Auslesen in der App, und der Bildschirm bleibt so lange an. Verlässt man die App, friert iOS sie ein und kann sie beenden. Beim Zurückkehren geht es weiter.
Modellverteilung: Download statt App-Paket
Ein Modell dieser Größe gehört nicht in das App-Paket selbst. BonBunker lädt es deshalb beim ersten Beleg von Hugging Face herunter. Im WLAN startet der Download automatisch, im Mobilfunknetz fragt die App vorher. Wichtig für den Datenschutz: Beim Download werden keine Belege übertragen, die App holt nur das Modell.
Ein Stolperstein, der uns Zeit gekostet hat: Ursprünglich lief der Download über den Downloader des Modell-Plugins als WorkManager-Foreground-Task, ohne deklarierten Service-Typ. Ab Android 14 beendet das System die App in diesem Fall. Die Lösung war, den Typ im Manifest nachzutragen und das Modell im eigenen Dienst herunterzuladen.
Vertrauen durch Prüfbarkeit
Auch ein gut trainiertes Modell verliest sich manchmal, besonders bei zerknitterten oder verblassten Bons. Statt das zu verstecken, haben wir die Oberfläche darum herum gebaut: Jedes Ergebnis steht neben dem Foto, die Summenprüfung markiert Unstimmigkeiten, und jede Angabe lässt sich korrigieren. Wer möchte, kann einzelne Belege spenden, um die Erkennung zu verbessern, aber nur nach ausdrücklicher Zustimmung für jeden einzelnen Beleg.
Was wir gelernt haben
- Die App muss exakt so lesen, wie trainiert wurde. Prompt, Bildgrößen, Stückelung und Dekodierung sind kein Implementierungsdetail, sondern Teil des Modells.
- Pixel sind kostbar. Erst zuschneiden, dann skalieren. Und lieber in überlappende Stücke schneiden, als einen langen Bon auf eine Bildgröße zu quetschen.
- Prozessabbrüche sind der Normalfall, nicht die Ausnahme. Warteschlange, Wiederaufnahme und eine Obergrenze für Neuversuche gehören von Anfang an in die Architektur.
- Android-Versionen ändern die Spielregeln. Seit Android 14 braucht jeder Foreground Service einen deklarierten Typ, auch der in einer Bibliothek.
Ausprobieren oder selbst bauen
BonBunker ist für Android und iOS verfügbar. Wenn du sehen willst, wie sich On-Device KI im Alltag anfühlt, probier es aus.
Du überlegst, KI direkt in deine eigene App zu bringen, auf dem Gerät oder in der eigenen Infrastruktur? Als App- und Webentwickler aus Dresden unterstützen wir dich von der Modellauswahl bis zur fertigen App. Schreib uns an kontakt@daturex.de.
Verwandte Beiträge
Als App-Agentur in Dresden entwickeln wir native iOS/Android- und Cross-Platform-Apps für KMU, Startups und Konzerne. Von der UI/UX-Konzeption bis zum App-Store-Launch — Festpreis ab 15.000 €.
→ App-Entwicklung Dresden anfragenKI-Lösungen für Ihr Unternehmen
Die DATUREX GmbH entwickelt individuelle KI-Lösungen — von der Strategie bis zur Implementierung. DSGVO-konform, lokal und sicher.
- → KI-Beratung — Strategie, Implementierung & Training
- → KI-Chatbots — Support & Vertrieb automatisieren
- → KI-Fördermittel — SAB- und BAFA-Zuschüsse in Sachsen
Neueste Kommentare