OvisOCR2 Fine-Tuning: Ein Dokumentmodell lernt Kassenbons lesen
OvisOCR2 ist eines der spannendsten kleinen Dokumentmodelle des Jahres: Es wandelt ganze Seiten in sauberes Markdown um und ist dabei kompakt genug, um über den Einsatz auf dem Smartphone nachzudenken. Für unsere App BonBunker brauchten wir aber kein Markdown, sondern strukturierte Belegdaten: Geschäft, Datum, Summe und jede einzelne Position. Dieser Beitrag beschreibt unser OvisOCR2 Fine-Tuning für Kassenbons, vom Modellvergleich bis zum Modell auf dem Handy.
Was ist OvisOCR2?
OvisOCR2 ist ein End-to-End-Modell für das Parsen von Dokumentseiten, veröffentlicht von ATH-MaaS auf Hugging Face. Die wichtigsten Eckdaten laut Model Card:
- Größe: rund 0,8 Milliarden Parameter (die Model Card listet 0,9B in BF16).
- Basis: ein nachtrainiertes Qwen3.5-0.8B.
- Ausgabe: Markdown in natürlicher Lesereihenfolge, Formeln als LaTeX, Tabellen als HTML, Bildbereiche mit Koordinaten.
- Lizenz: Apache 2.0, also auch für kommerzielle Projekte und eigenes Fine-Tuning nutzbar.
- Benchmarks: Laut den Autoren erreicht es auf OmniDocBench v1.6 einen Gesamtwert von 96,58 und ist damit das erste End-to-End-Modell an der Spitze dieses Leaderboards, das bisher von Pipeline-Ansätzen dominiert wurde. Der technische Bericht ist auf arXiv erschienen und in der Model Card verlinkt.
Modellvergleich: Warum OvisOCR2?
Für ein On-Device-Szenario zählen drei Dinge: Das Modell muss klein sein, es muss Layout und Text gemeinsam verstehen, und die Lizenz muss Anpassungen erlauben. Wir haben vier kleine Bild-Sprach-Modelle gegeneinander antreten lassen:
- Gemma 4 E2B
- Qwen3.5-2B
- Qwen3.5-0.8B
- OvisOCR2 (0,8B, auf OCR spezialisiert)
Dazu kam eine zweistufige Variante: erst klassische Texterkennung, dann Umwandlung in JSON.
Das überraschende Ergebnis: Nach dem Fine-Tuning lagen alle Modelle innerhalb von rund zwei Punkten. Die Wahl fiel auf OvisOCR2, weil es bei praktisch gleicher Genauigkeit nur etwa ein Drittel so groß ist wie Gemma 4 E2B und die Konvertierung fürs Handy ohne messbaren Verlust überstanden hat. Auf einem Smartphone sind das die Kriterien, die am Ende über Download-Größe, Speicherbedarf und Wartezeit entscheiden.
Warum Kassenbons schwerer sind als sie aussehen
- Thermopapier: verblasst, zerknittert, gewellt, oft schräg fotografiert.
- Abkürzungen: „BIO VOLLM. 3,8% 1L“ statt eines lesbaren Produktnamens.
- Mengenzeilen: „2 x 1,19“ in einer eigenen Zeile über oder unter dem Artikel.
- Pfand, Rabatte und Coupons: negative Beträge, die sich auf andere Zeilen beziehen.
- Steuerkennzeichen: Buchstaben wie A und B am Zeilenende, die leicht für Teil des Preises gehalten werden.
- Länge: Wocheneinkäufe mit dutzenden Positionen, verteilt auf mehrere Fotos.
- Vielfalt: Jede Kette, jede Kassensoftware hat ihr eigenes Layout.
Vom Markdown zum Beleg-Schema
Der wichtigste Schritt war, die Aufgabe neu zu definieren: Statt eine Seite originalgetreu als Markdown abzubilden, gibt das Modell direkt ein festes JSON-Schema aus. So sieht es aus:
{
  "store": "",
  "store_misc": "",
  "date_time": "",
  "articles": [
    { "name": "", "misc": "", "quantity": "", "price": "" }
  ],
  "total": ""
}
Geschäft, Zeitpunkt, Artikel mit Menge und Preis sowie die Gesamtsumme haben feste Felder, dazu kommen Zusatzfelder für sonstige Angaben zum Geschäft und zu den Artikeln. Ein festes Schema hat einen großen Vorteil: Die App kann das Ergebnis automatisch prüfen. Passen die Artikel zur Gesamtsumme, ist das ein gutes Zeichen. Passen sie nicht, weist BonBunker darauf hin, und du korrigierst den Beleg mit dem Foto daneben.
Lange Bons aus mehreren Fotos werden vor dem Auslesen zu einem hohen Bild gestapelt, auf 1024 Pixel Breite skaliert und in überlappende Stücke geschnitten. Alle Stücke gehen gemeinsam in einen Prompt, und das Modell gibt ein einziges JSON aus. Die Details dazu stehen in On-Device KI in der Praxis. Wichtig für das Training: Genau diese Stückelung wird auch beim Training verwendet. Die App liest also exakt so, wie das Modell gelernt hat.
Der Datensatz
- Umfang: rund 4.000 Kassenbons.
- Herkunft: eine Mischung aus eigenen Fotos und öffentlichen Bon-Datensätzen. Synthetische Daten haben wir nicht verwendet.
- Annotation: Die Labels wurden von einem großen Modell vorerzeugt. Stichproben zeigen, dass sie noch vereinzelt Tippfehler enthalten. Die Qualität der Labels ist damit einer der nächsten Hebel für bessere Ergebnisse.
- Aufteilung: rund 3.700 Belege für das Training und 192 für die Auswertung, mit festem Zufalls-Seed. Ein separates Test-Set gibt es bisher nicht.
Langfristig sollen auch gespendete Belege helfen, die Erkennung zu verbessern. Gespendet wird in BonBunker nur, wenn Nutzer für jeden einzelnen Beleg vorher zustimmen. Die Spenden lassen sich in den Einstellungen widerrufen.
Das Trainings-Setup
- Verfahren: volles Fine-Tuning, kein LoRA. Nur die Token-Embeddings bleiben eingefroren.
- Hardware: eine einzelne Workstation-GPU (NVIDIA RTX PRO 6000 mit 96 GB).
- Dauer: etwa eine Stunde pro Trainingslauf beim 0,8B-Modell.
- Framework: PyTorch mit Hugging Face Transformers und eigener Trainingsschleife.
- Hyperparameter: 3 Epochen, Lernrate 1e-5.
Eine Stunde pro Lauf auf einer einzigen GPU heißt: Man kann an einem Tag viele Varianten ausprobieren. Für kleine Teams ist das vielleicht der wichtigste Vorteil kleiner Modelle.
Evaluation: Woran misst man einen Kassenbon-Parser?
Klassische OCR-Metriken wie die Zeichenfehlerrate sagen wenig darüber, ob ein Haushaltsbuch stimmt. Ein falsches Komma im Preis ist schlimmer als ein Tippfehler im Produktnamen. Wir messen deshalb auf Feldebene: Summe, Datum und JSON-Gültigkeit pro Beleg. Für die Artikel werden erkannte und erwartete Positionen einander zugeordnet und dann pro Feld exakt verglichen, also Name, Menge und Preis. Daraus ergibt sich zusätzlich eine Gesamtpunktzahl von 0 bis 100.
| Kennzahl (192 Belege) | Qwen3.5-0.8B, untrainiert | OvisOCR2, nachtrainiert |
|---|---|---|
| Summe korrekt | 86 % | 94 % |
| Datum korrekt | 68 % | 84 % |
| Gültiges JSON | 96 % | 99 % |
| Artikelanzahl korrekt | 67 % | 82 % |
| Artikelnamen exakt | 63 % | 74 % |
| Preise exakt | 82 % | 88 % |
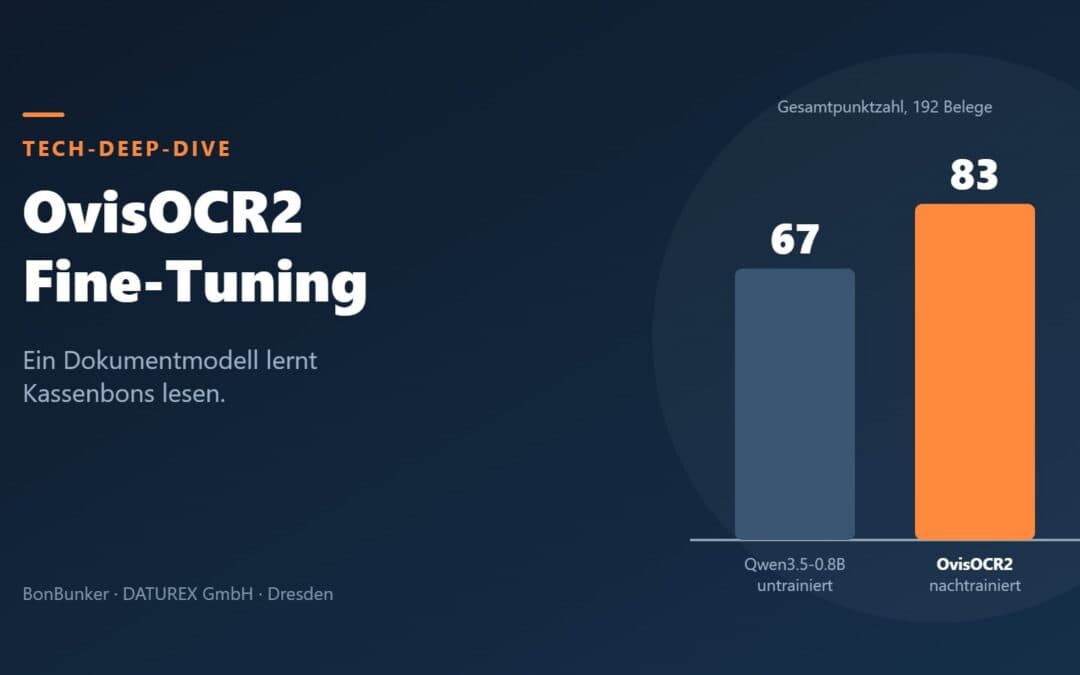
| Gesamtpunktzahl (0–100) | 67 | 83 |
Zur Einordnung: OvisOCR2 selbst haben wir untrainiert nicht auf dieser Aufgabe gemessen. Als Basis dient deshalb das Standardmodell gleicher Größe, Qwen3.5-0.8B, auf dem OvisOCR2 aufbaut. Nachtrainiert kommt Qwen3.5-0.8B auf 82 Punkte, OvisOCR2 auf 83.
Die Zahlen zeigen auch, wo die Grenzen liegen: Summe und Preise sitzen meist, bei den exakten Artikelnamen klappt es in rund drei von vier Fällen. Genau deshalb zeigt BonBunker jedes Ergebnis neben dem Foto und lässt dich alles korrigieren.
Vom Checkpoint aufs Smartphone
Ein trainiertes Modell ist erst die halbe Miete. Auf dem Handy zählen Speicherbedarf und Laufzeit. Das nachtrainierte Modell wird quantisiert und ins .litertlm-Format konvertiert, laut unseren Messungen ohne messbaren Genauigkeitsverlust. In der Flutter-App läuft es über Flutter Edge AI mit LiteRT-LM als Backend. Bereitgestellt wird es über Hugging Face. Der einmalige Download umfasst etwa 1,9 GB, das Auslesen eines Belegs dauert auf einem Galaxy S22 Ultra rund 5 Minuten und läuft im Hintergrund.
Auch beim Dekodieren halten wir uns an das Training: Die App liest mit Temperatur 0 (greedy), damit das Ergebnis wiederholbar ist, bei 8192 Tokens Kontext und höchstens 2048 Tokens Antwort.
Lessons Learned
- Fine-Tuning schlägt Modellgröße. Nach dem Training lagen Modelle zwischen 0,8 und rund 2 Milliarden Parametern innerhalb von zwei Punkten. Für das Handy gewinnt dann das kleinste.
- Training und Inferenz müssen identisch sein. Prompt, Bildstückelung und Dekodierung sind Teil des Modells. Jede Abweichung in der App kostet Genauigkeit.
- Die Konvertierung gehört in die Modellauswahl. Ein Modell, das auf der GPU glänzt, aber bei der Quantisierung verliert, hilft auf dem Smartphone nicht.
- Die Labels sind der nächste Hebel. Automatisch vorerzeugte Annotationen sind ein schneller Start, aber Tippfehler in den Labels landen auch in den Vorhersagen. Ein sauber geprüftes Test-Set steht als Nächstes auf der Liste.
Das Ergebnis ausprobieren
Das nachtrainierte Modell steckt in BonBunker, verfügbar für Android ab Version 11 und für iOS. Wie die App den Rest der Pipeline löst, liest du in On-Device KI in der Praxis.
Du möchtest ein Open-Source-Modell auf deine eigenen Dokumente nachtrainieren, etwa Lieferscheine, Rechnungen oder Formulare? Sprich uns an: kontakt@daturex.de.
Verwandte Beiträge
Als App-Agentur in Dresden entwickeln wir native iOS/Android- und Cross-Platform-Apps für KMU, Startups und Konzerne. Von der UI/UX-Konzeption bis zum App-Store-Launch — Festpreis ab 15.000 €.
→ App-Entwicklung Dresden anfragen
Neueste Kommentare